数据库
MySQL 逻辑架构
分为连接层、服务层、存储引擎层
连接层
系统(客户端)访问 MySQL 服务器前,需要先建立 TCP 连接。三次握手成功后,MySQL 服务器会对账号和密码进行身份认证,并检查用户权限。
服务层
SQL Interface:SQL 接口
接收用户的 SQL 命令,并返回查询结果。
Caches & Buffers:查询缓存组件
查询缓存命中率不高,MySQL 8.0 已经删除该功能。只有完全相同的查询才可能命中查询缓存。
Parser:解析器
对 SQL 语句进行语法分析和语义分析,将 SQL 语句转换为内部数据结构。
Optimizer:查询优化器
SQL 语句在语法解析之后、真正执行之前,会由查询优化器确定执行路径,生成执行计划。
存储引擎层
负责数据的存储和提取。MySQL 5.5 之后默认采用 InnoDB 引擎。
InnoDB 和 MyISAM 的区别
| 对比项 | InnoDB | MyISAM |
|---|---|---|
| 事务 | 支持 | 不支持 |
| 外键 | 支持 | 不支持 |
| 锁粒度 | 支持表锁、行锁,默认行锁 | 只支持表锁 |
| 崩溃恢复 | 支持 redo log 等恢复机制 | 崩溃恢复能力较弱 |
count(*) | 一般需要扫描或利用优化策略统计 | 保存表总行数,简单场景下返回很快 |
| 适用场景 | 事务、并发写入、数据一致性要求高 | 读多写少、对事务要求不高的旧场景 |
一条 SQL 语句在数据库框架中的执行流程
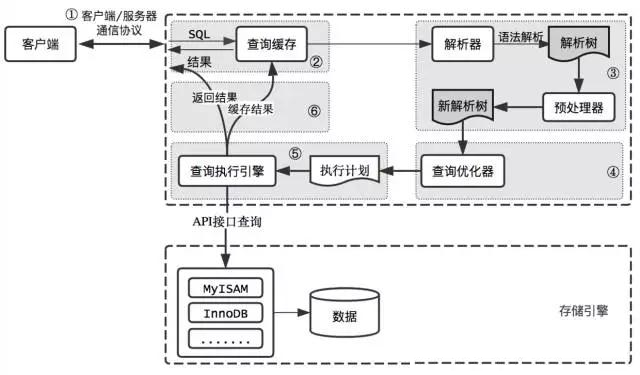
- 应用程序把 SQL 语句发送给 MySQL 服务器。
- MySQL 进行连接校验、权限校验。
- 解析器对 SQL 进行词法、语法和语义分析。
- 优化器生成执行计划。
- 执行器按照执行计划调用存储引擎接口。
- 存储引擎读取或写入数据,并把结果返回给执行器。
- MySQL 将查询结果返回给客户端。
数据库三大范式是什么?
第一范式
数据表的每一列都是不可再分的原子数据项。
第二范式
要求非主属性完全依赖于候选键,不能只依赖候选键的一部分。
满足1NF,非主属性完全函数依赖于候选码
第三范式
要求非主属性不依赖于其他非主属性,即每列都和主键有直接关系,不存在传递依赖。
符合2NF,并且消除了非主属性对于候选码的传递函数依赖。
总结:
第一范式:字段不可分。第二范式:有主键,非主键字段依赖主键。第三范式:非主键字段不能相互依赖。
查询性能的优化方法?
- 减少请求的数据量
- 只返回必要的列:最好不要使用 SELECT * 语句
- 只返回必要的行:使用 LIMIT 语句来限制返回的数据
- 缓存重复查询的数据:使用缓存可以避免在数据库中进行查询,特别在要查询的数据经常被重复查询时,缓存带来的查询性能是非常明显的
- 减少服务端扫描的行数:
- 使用索引来覆盖查询
索引
索引(Index)是帮助 MySQL 高效获取数据的数据结构。
索引的优缺点
优点:降低数据库 I/O 成本,加速查询和表连接,减少分组、排序的时间;唯一索引还可以保证数据唯一性。
缺点:创建和维护索引需要时间,索引会占用磁盘空间;写入、更新、删除数据时还需要维护索引,可能降低写入性能。
索引的分类
从功能逻辑上说,索引主要有 4 种,分别是普通索引(允许在定义索引的列中插入重复值和空值)、唯一索引(唯一,允许有空值)、主键索引(唯一,不允许有空值)、全文索引(支持值的全文查找)。按照物理实现方式 ,索引可以分为 2 种:聚簇索引和非聚簇索引。 按照作用字段个数进行划分,分成单列索引和联合索引。
聚簇索引
聚簇索引是对磁盘上实际数据重新组织,然后按指定的一个或多个列的值排序的算法。
聚簇索引的特点是存储数据的顺序和索引顺序一致。
InnoDB 中主键索引就是聚簇索引,一张表只能有一个聚簇索引。
辅助索引(非聚簇索引)
辅助索引是根据索引键创建的一棵 B+ 树。与聚簇索引不同,辅助索引的叶子节点一般存放索引键值和对应的主键值。通过辅助索引查找数据时,如果查询列不能被该索引覆盖,就需要再根据主键值查聚簇索引,这个过程称为回表。
联合索引
联合索引是同时为多个列建立索引。例如 (c2, c3) 联合索引会先按照 c2 排序;当 c2 相同,再按照 c3 排序。因此联合索引使用时要注意最左前缀原则。
适合建立索引的情况:
- 在频繁使用的、需要排序的字段上建立索引
- 字段的数值有唯一性的限制
- 频繁作为 WHERE 查询条件的字段
- 经常 GROUP BY 和 ORDER BY 的列
- DISTINCT 字段需要创建索引
不适合建索引的情况:
- 对于查询中很少涉及的列或重复值比较多的列,不适合建立索引
- 对于一些特殊的数据类型,不适合建立索引,比如文本字段 (text)等
- 在where中使用不到的字段,不要设置索引
- 数据量小的表最好不要使用索引
- 有大量重复数据的列上不要建立索引
- 避免对经常更新的表创建过多的索引
什么时候索引失效?
1、索引列参与表达式计算。
SELECT sname FROM stu WHERE age + 10 = 30;2、函数运算:
SELECT sname FROM stu WHERE LEFT(date, 4) < 1900;3、LIKE 左侧通配符模糊查询:
SELECT * FROM manong WHERE uname LIKE '码农%'  -- 可能走索引
SELECT * FROM manong WHERE uname LIKE '%码农%' -- 通常不走索引
4、字符串与数字比较不走索引:
CREATE TABLE a (a char(10));
EXPLAIN SELECT * FROM a WHERE a = '1'; -- 走索引
EXPLAIN SELECT * FROM a WHERE a = 1;   -- 可能因为隐式类型转换导致索引失效
5、查询条件中有 OR,如果前后存在非索引列,可能导致索引失效。
SELECT * FROM dept WHERE dname='xxx' or loc='xx' or deptno=45;6、正则表达式通常不使用索引。
7、MySQL 优化器会估算执行成本,如果认为全表扫描比使用索引更快,就可能不使用索引。使用不等于(!= 或 <>)时,也可能导致索引利用效果变差。
如何判断数据库的索引有没有生效?
使用 EXPLAIN 命令查看语句的执行计划。可以通过与索引有关的信息判断是否命中索引,例如 possible_keys、key、key_len 等字段,分别表示可能使用的索引、实际使用的索引以及索引长度。
索引的底层数据结构
索引的数据结构和具体存储引擎的实现有关,常用的有Hash索引,B+树索引等。InnoDB存储引擎默认索引实现为B+树索引。
B 树(平衡多路查找树)
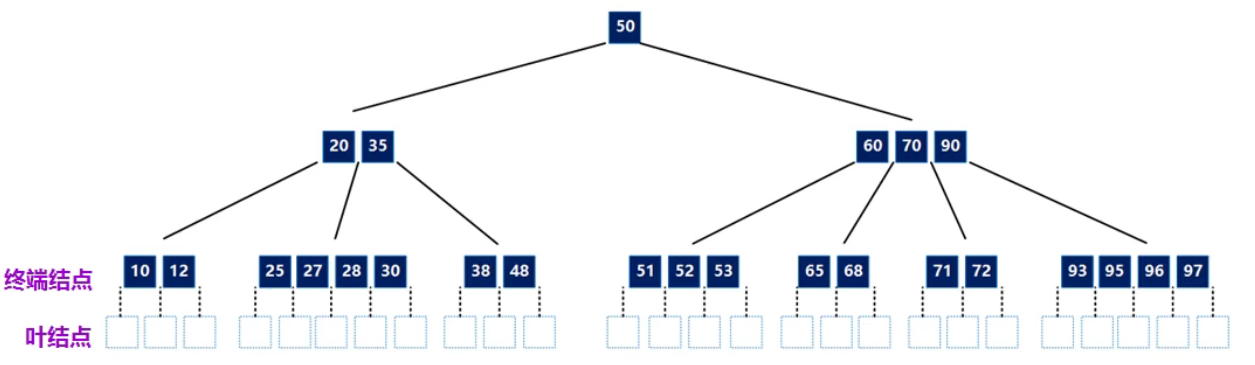
B 树是一种平衡的多路查找树。通常说 m 阶 B 树,指一个节点最多有 m 个子节点。
- 每个节点最多只有m个子节点
- 每个非叶子节点(除了根)具有至少[m/2]子节点
- 如果根不是叶节点,则根至少有两个子节点
- 具有k个子节点的非叶节点包含k -1个键
- 所有叶子都出现在同一水平,没有任何信息(高度一致)
B+ 树
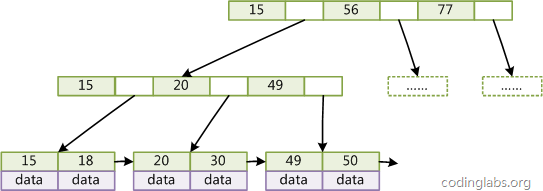
- 所有的叶子结点中包含了全部关键字的信息,及指向含有这些关键字记录的指针,且叶子结点本身依关键字的大小自小而大的顺序链接。 (而B树的叶子节点并没有包括全部需要查找的信息);
- 所有的非终端结点可以看成是索引部分,结点中仅含有其子树根结点中最大(或最小)关键字。 (而B树的非终节点也包含需要查找的有效信息);
B 树与 B+ 树的差异
- B 树的非叶子节点和叶子节点都可以存放数据;B+ 树通常只有叶子节点存放完整数据,非叶子节点主要用于索引。
- B+ 树的叶子节点通过链表连接,适合范围查询和顺序扫描。
- B+ 树的非叶子节点只存放索引键,单个节点能容纳更多关键字,树高更低,更适合磁盘索引。
- InnoDB 默认使用 B+ 树作为主要索引结构。
事务
事务的特性
原子性(Atomicity,A)
是指事务是一个不可分割的工作单位,要么全部提交,要么全部失败回滚。
一致性(Consistency,C)
一致性是指事务执行前后,数据从一个合法性状态变换到另外一个合法性状态 。这种状态是语义上的而不是语法上的,跟具体的业务有关。
隔离性(Isolation,I)
事务的隔离性是指一个事务的执行不能被其他事务干扰,即一个事务内部的操作及使用的数据对并发的其他事务是隔离的,并发执行的各个事务之间不能互相干扰。
持久性(Durability,D)
持久性是指一个事务一旦被提交,它对数据库中数据的改变就是永久性的 ,接下来的其他操作和数据库故障不应该对其有任何影响。
事务的隔离级别
- 读未提交(READ UNCOMMITTED):最低隔离级别,允许读取其他事务尚未提交的数据。
- 读提交(READ COMMITTED):只能读取其他事务已经提交的数据。
- 可重复读(REPEATABLE READ):同一事务内多次读取同一数据,结果保持一致,除非数据被本事务自己修改。
- 串行化(SERIALIZABLE):最高隔离级别,事务串行执行,隔离性最强,但并发性能最低。
| 隔离级别 | 脏读 | 不可重复读 | 幻读 |
|---|---|---|---|
| READ UNCOMMITTED | 可能 | 可能 | 可能 |
| READ COMMITTED | 不可能 | 可能 | 可能 |
| REPEATABLE READ | 不可能 | 不可能 | 可能 |
| SERIALIZABLE | 不可能 | 不可能 | 不可能 |
默认隔离级别:
MySQL:REPEATABLE READ
Oracle:READ COMMITTED
MySQL 在 REPEATABLE READ 隔离级别下是可以解决幻读问题的,解决方案有两种,可以使用 MVCC 方案解决,也可以采用加锁方案解决。(间隙锁)
什么是脏读、不可重复读、幻读?
- 脏读:事务 A 读到了事务 B 尚未提交的数据。
- 不可重复读:事务 A 先后两次读取同一行数据,结果不一致。原因通常是事务 B 在两次读取之间提交了修改。
- 幻读:事务 A 按照同一条件先后两次查询,结果集行数不一致。原因通常是事务 B 在两次查询之间提交了插入或删除。
MVCC(Multi-Version Concurrency Control,多版本并发控制)
通过数据行的多个版本管理来实现数据库的并发控制,简单来说就是保存数据的历史版本。可以通过比较版本号决定数据是否显示出来。读取数据的时候不需要加锁可以保证事务的隔离效果。
- 读—读:不存在并发问题,也不需要并发控制。
- 读—写:可能造成事务隔离性问题,例如脏读、不可重复读、幻读。
- 写—写:可能存在更新丢失等并发问题。
MVCC 可以为数据库解决以下问题:
- 在并发读写数据库时,可以做到在读操作时不用阻塞写操作,写操作也不用阻塞读操作,提高了数据库并发的读写性能
- 可以解决脏读、不可重复读、幻读等事务隔离问题,但不能解决更新丢失问题。
锁
操作类型划分
- 共享锁(S Lock),读锁,针对同一份数据,多个事务的读操作可以同时进行而不会互相影响。
- 排他锁(X Lock),写锁,当前写操作没有完成前,它会阻断其他写锁和读锁。
粒度划分
表级锁:开销小,加锁快,不容易出现死锁。锁定粒度大,发生锁冲突的概率最高,并发度最低。
行锁:开销大,加锁慢,可能出现死锁。锁粒度小,发生锁冲突的概率低,并发度最高。
页级锁
意向锁(表级别)
- 意向共享锁(IS Lock):事务有意向对表中的某些行加共享锁(S Lock)。
- 意向排他锁(IX Lock):事务有意向对表中的某些行加排他锁(X Lock)。
InnoDB 存储引擎的锁算法有哪些?
- Record Lock:单个行记录上的锁。
- Gap Lock:间隙锁,锁定一个范围,但不包含记录本身。
- Next-Key Lock∶Gap Lock+Record Lock,锁定一个范围,并且锁定记录本身。
其他
主从复制是什么?主从复制中涉及到哪三个线程?
主从复制是什么?
主从复制是用来建立一个和主数据库完全一样的数据库环境,称为从数据库;主数据库一般是实时的业务数据库,从数据库的作用和使用场合一般有几个:
- 一是作为后备数据库,主数据库服务器故障后,可切换到从数据库继续工作;
- 二是可在从数据库作备份、数据统计等工作,这样不影响主数据库的性能;
主从复制中涉及到哪三个线程?
- binlog 线程:负责将主服务器上的数据更改写入二进制日志(Binary Log)。
- I/O 线程:负责从主服务器读取二进制日志,并写入从服务器的中继日志(Relay Log)。
- SQL 线程:负责读取中继日志并重放其中的 SQL。
内存、磁盘
索引的结构组织要尽量减少查找过程中磁盘 I/O 的存取次数。
内存存取的时间仅与存取次数呈线性关系,因为不存在机械操作,两次存取的数据的“距离”不会对时间有任何影响。
机械硬盘结构:磁盘转动,磁头沿半径方向移动(实际是斜切向运动)。磁盘的每个同心环叫做一个磁道,所有半径相同的磁道组成一个柱面。磁道被沿半径线划分成一个个小的段,每个段叫做一个扇区,每个扇区是磁盘的最小存储单元。
当需要从磁盘读取数据时,系统会将数据逻辑地址传给磁盘,磁盘的控制电路按照寻址逻辑将逻辑地址翻译成物理地址,即确定要读的数据在哪个磁道,哪个扇区。为了读取这个扇区的数据,需要将磁头放到这个扇区上方,为了实现这一点,磁头需要移动对准相应磁道,这个过程叫做寻道,所耗费时间叫做寻道时间,然后磁盘旋转将目标扇区旋转到磁头下,这个过程耗费的时间叫做旋转时间。
局部性原理与磁盘预读
由于存储介质的特性,磁盘存取比主存慢很多,再加上机械运动开销,磁盘访问速度往往远低于内存。因此为了提高效率,需要尽量减少磁盘 I/O。
磁盘读取通常不是严格按需读取,而是会进行预读:即使只需要一个字节,磁盘也可能从当前位置开始顺序读取一定长度的数据放入内存。这样做的理论依据是局部性原理:当一个数据被访问时,它附近的数据也很可能马上被访问。